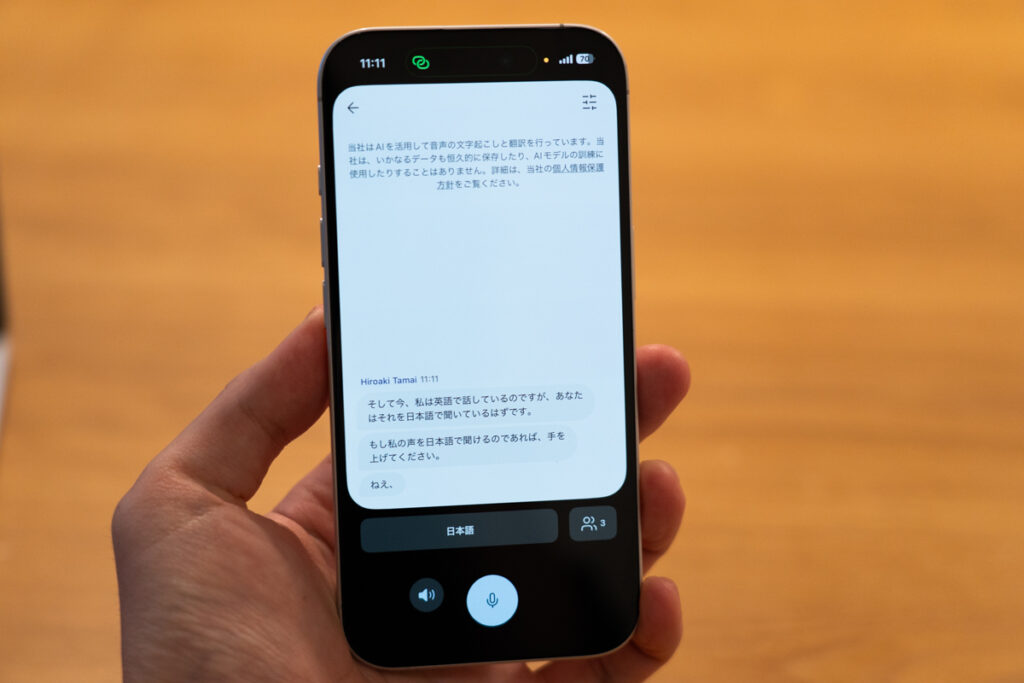
 スマートフォンで参加したグループ会話。英語の説明が日本語の字幕で表示される(筆者撮影)
言語AIサービスのDeepLが、リアルタイム音声翻訳ソリューション「DeepL Voice」の大幅なアップデートと、AIアシスタントとの接続規格「Model Context Protocol(MCP)」への対応に関する説明会を開催した。
【写真】DeepL Voiceを会議とスマホで体験 現地写真と新機能の図版
これまで提供されてきた音声からテキスト(字幕)への変換に加え、話者の声質を維持したまま音声で出力する「音声から音声への翻訳」が正式に一般提供された。さらに、オンライン会議の利便性を高めるデスクトップアプリや、各種AIツールからDeepLの翻訳を呼び出せるMCP連携など、現場の業務効率化を見据えた機能が紹介された。
■字幕から音声へ 声の特徴や抑揚も伝える会議翻訳
新たに提供が開始されたWindowsおよびMac向けの「DeepL Voice デスクトップアプリ」は、Zoom、Microsoft Teams、Google Meetといった主要なオンライン会議ツールと連動する。従来のブラウザ版では会議URLを手動で貼り付けてボットを招待する必要があったが、デスクトップアプリでは参加中の会議を検知して連携できるようになった。
目玉となるのが「音声から音声への直接翻訳(Voice to voice)」の実装だ。話者が発話した内容が、相手側のスピーカーから翻訳先の言語の音声として再生される。
あわせて搭載された「スピーカーマッチ」は、あらかじめ用意された無機質な合成音声ではなく、話者本人の声質をリアルタイムに解析して模倣した音声を生成する機能だ。これにより、複数人が参加する会議でも「誰が話しているか」を自然に識別しやすくなる。疑問文の抑揚や発話の強弱、トーンといったニュアンスも反映される。事前の音声サンプルのアップロードや登録は不要で、音声データは処理後にサーバーへ保持・蓄積されないセキュリティ設計となっている。
主な用途としては、海外拠点とのオンライン定例会議やプロジェクトの進捗確認、多国籍なメンバーを対象とした採用面接などが想定されている。
■QRコードで参加し自分の言語で聞く 対面で活用できる「グループ会話」
対面コミュニケーション向けの「DeepL Voice for Conversations」には、複数人で使える「グループ会話」機能が追加された。従来の端末1台を交互に向ける方式から進化し、ホストが作成したバーチャルルームに各参加者が自身の端末から参加する形式をとる。
ホスト以外の参加者は、DeepLのライセンスや専用アプリを持っていなくても、QRコードを読み取ってブラウザから入室できる。
■ChatGPTやClaudeからDeepLを呼び出す MCP連携で文書翻訳も
テキスト翻訳および文書翻訳の領域ではMCPへの対応が発表された。これにより、Claude、ChatGPT、Microsoft CopilotなどのAIアシスタントから、DeepLの翻訳エンジンを直接呼び出せる。
サーバーはDeepL側がホストするリモート形式で提供されるため、利用者が自前でサーバー環境を構築する必要はない。AIアシスタントで調査や文章作成を行いながら、画面を切り替えることなく「この文章をDeepLで翻訳して」「このPDF資料をフォーマットを維持して翻訳して」と指示を出すだけで完結する。
WordやExcel、PowerPoint、PDFなどのレイアウトを保った文書翻訳や、企業ごとの用語集の適用にも対応しており、外国語の請求書確認や契約書のチェックといったバックオフィス業務の負荷軽減につながる。
■韓国語の返答が日本語で届く Zoomで採用面接を体験
会場では、PCを用いたオンライン会議と、スマートフォンを用いた対面会話の2つのデモを実際に体験した。
まず、デスクトップアプリを用いた「DeepL Voice for Meetings」の検証として、遠隔地にいる韓国語話者のスタッフとZoomをつなぎ、用意された台本に沿って会話を行った。担当したシナリオは「海外プロジェクトの採用面接」だ。
筆者が日本語で「当社の海外プロジェクトに応募された理由を教えていただけますか」とマイクに向かって話すと、相手側には韓国語に翻訳された音声が届く。続いて相手が韓国語で応答すると、手元のスピーカーから流暢な日本語の音声が返ってきた。
出力された音声は機械的な棒読みではなく、相手の話し方のテンポや声のトーンが反映されており、肉声に近い感覚で聞き取ることができた。
■アプリ不要で英語の説明を日本語に スマホで試す「グループ会話」
続いて、対面環境を想定した「グループ会話」のデモを試した。説明担当者が作成したバーチャルルームのQRコードを筆者のスマートフォンで読み取ると、ブラウザ上で名前と言語(日本語)を選択する画面が立ち上がり、すぐに入室できた。
ワイヤレスイヤホンを装着した状態で担当者が英語で説明を始めると、イヤホンからほぼリアルタイムで日本語の音声が再生された。同時に、スマートフォンの画面上には日本語に訳されたテキストが次々と表示されていく。
翻訳音声をマイクが拾い直してループするのを防ぐため、イヤホンの使用が推奨されているが、画面上のスピーカーアイコンをタップして音声をミュートにし、テキストの字幕表示だけで追うことも可能だった。それにより、周囲が騒がしい場所や、音声を流せない状況でも柔軟に使い分けられる。
■翻訳音声の遅延をどう縮めるか 次世代モデルの開発も進む
DeepLの強みである高い翻訳精度に加え、今回のアップデートによって「話者の声やニュアンスを残した音声コミュニケーション」と「AIエージェント経由でのシームレスな文書・テキスト翻訳」の双方が実用段階に入った。
現状の音声対音声翻訳には処理の遅延が残るものの、DeepLでは現在、認識・翻訳・合成の3つのモデルを1つに統合し、遅延の大幅な削減と文脈判断の柔軟化を図る次世代モデルの開発も進めているという。言語の壁を感じさせない業務環境の実現に向け、今後のさらなる進化にも注目したい。