
 (写真:ITmedia AI+)(写真:ITmedia AI+)
米Anthropicは10月7日(現地時間)、同社モデルの中で最軽量の「Claude Haiku 5.5」(以下、Haiku 5.5)をリリースした。同社は「コスト重視、速度重視のタスクに適している」とうたっているが、日本のビジネスパーソンの利用シーンでその性能は本当に生きるのか。上位モデルの「Claude Sonnet 5.5」(以下、Sonnet 5.5)、競合モデルの「GPT-6 Luna」と比較検証した。
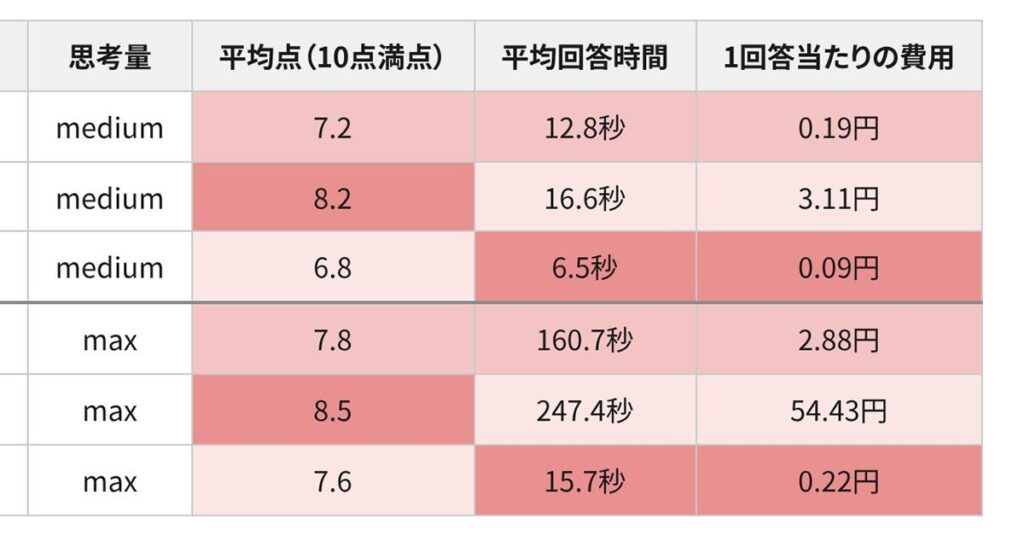
【表】検証結果
なお、今回の検証は10月9日時点のものであり、モデルの性能は今後のアップデートで変わる可能性がある。
検証方法
検証のお題は(1)納期遅延のお詫びメール、(2)走り書きメモからの議事録作成、(3)海外取引先からの英文メールの要約・論点整理・英文返信、の3つ。いずれもツールやWeb検索は使わせず、プロンプトに記載した情報だけで回答させた。
3モデルそれぞれで思考量の設定を「medium」と「max」にして各3回生成し、計54回答を得た。採点はAnthropicの「Claude Fable 5.1」(以下、Fable 5.1)と米OpenAIの「GPT-6 Astra」に10点満点で依頼し、両者の平均点(小数第二位を四捨五入)を主な指標とした。審査員にモデル名や設定は伏せた。9〜10点はそのまま使え、7〜8点は限定的な修正、5〜6点は重要な内容修正が要るという目安だ。
回答のクオリティと共に、回答にかかった時間とコストも検証する。時間はCLI(「Claude Code」と「Codex」)の起動から終了まで、費用はCLIが報告した実トークン量にAPI料金(1ドル=158円換算)を掛け合わせた換算値だ。平均時間は小数第二位、1回答当たりの費用は小数第三位を四捨五入している。
課題1:納期遅延のお詫びメール Haikuは字数を守るが、Lunaに及ばず
課題1は、取引先への納期遅延のお詫びメールを、数量・日付・代替案を明示しつつ400〜600字程度で書かせるタスク。結果は以下の通りだ。
回答のクオリティは、mediumではGPT-6 Lunaが平均8.8点で最も高く、Haiku 5.5は8.0点とSonnet 5.5(8.3点)と僅差だった。Haiku 5.5は依頼した字数を3回とも守り、Sonnet 5.5は1回超過した。maxではSonnet 5.5が9.5点と抜け出す一方、Haiku 5.5は7.8点とむしろ下がった。タスクによっては思考量を増やしてもクオリティが上がらない可能性がある。
時間と費用を見ると、mediumではSonnet 5.5が8.1秒で答え、Haiku 5.5(9.7秒)より速かった。費用はHaiku 5.5が1回答0.13円でSonnet 5.5(1.42円)の約11分の1だったが、GPT-6 Luna(0.09円)はさらに安い。maxのHaiku 5.5は123.8秒・2.05円と、mediumの約13倍の時間と約15倍の費用をかけて点を下げたことになる。Sonnet 5.5のmaxは9.5点と最も高いが、1回答に271.3秒・61.70円を要した。
Haiku 5.5の減点は、依頼にない返信期限を本文に加えたこと(medium)や、本文では「見込み」とした10月31日納品が日程一覧では確定納期のように書かれたこと(max)などで、GPT-6 Astraは後者を意思決定を誤らせる重要な誤りとして6点にした。定型文書であっても、AIに書かせた場合は日付などの重要な情報の確認は欠かせない。