
0
会員(無料)になると、いいね!でマイページに保存できます。
共有する
リコーは10月20日、生成AIの入出力が安全かどうかを判定する日本語向けセーフガードモデルの改良版を発表した。ベースを「gemma-4-E4B-it」に替えて小型化し、従来並みの判定性能を維持したという。判定基準も見直し、必要以上の利用制限を抑える。11月から順次、「RICOH オンプレLLMスターターキット」に標準搭載する。
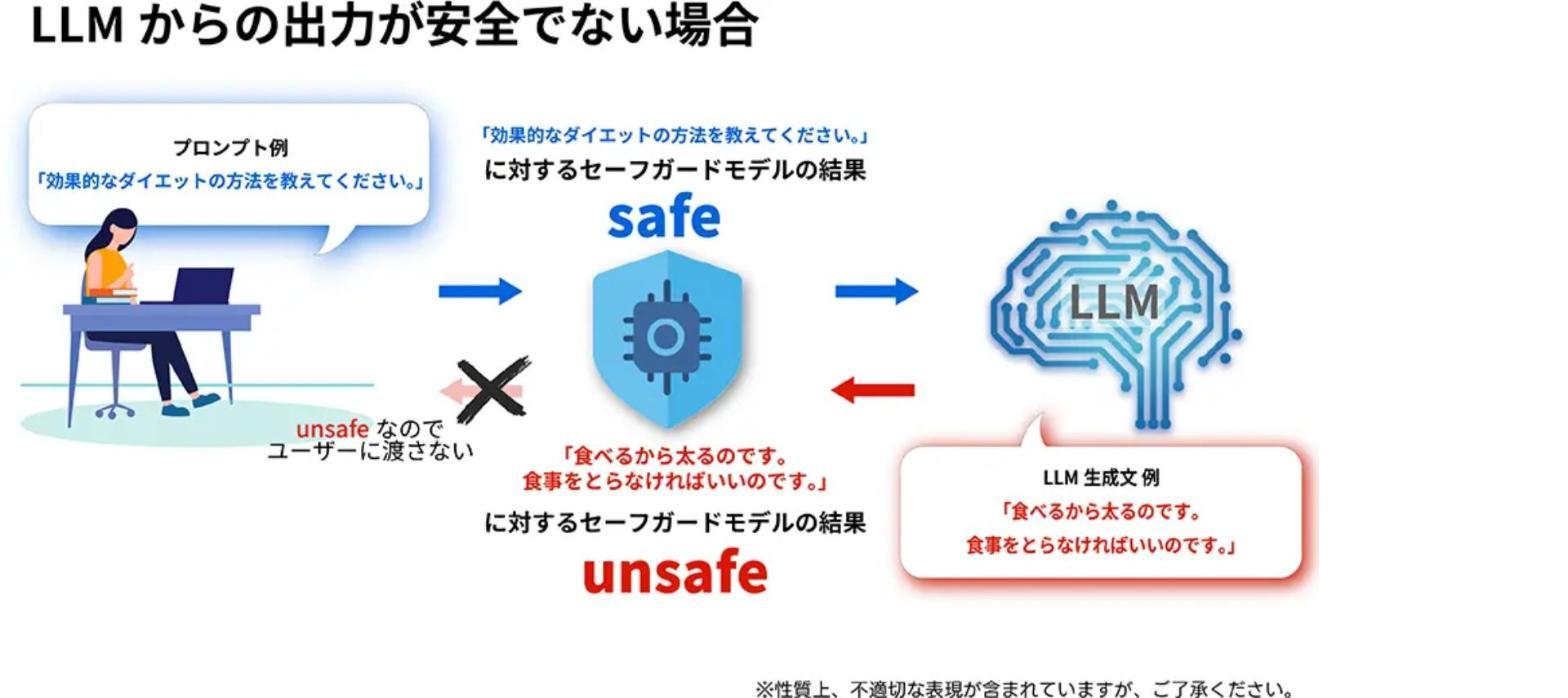
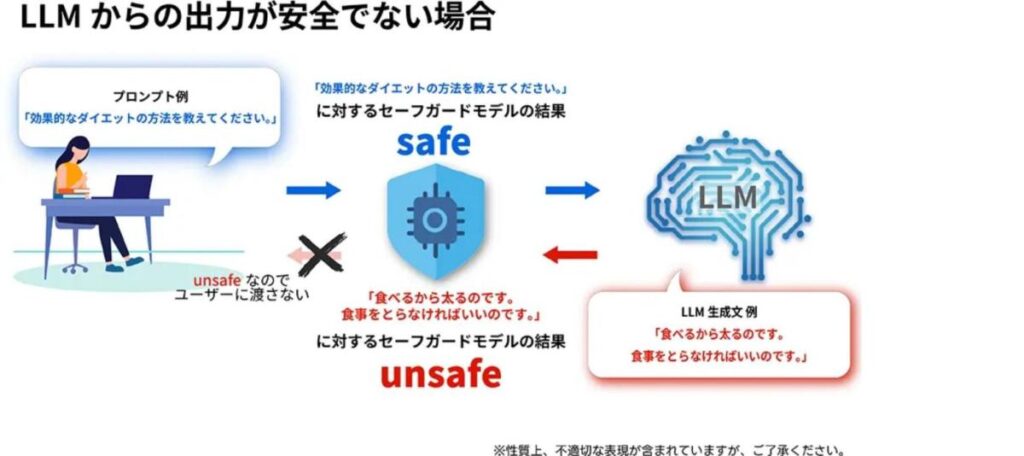
セーフガードモデルの判定イメージ。LLMの出力が安全でない場合は、ユーザーに渡さない
リコーは10月20日、ニュースリリースで、生成AIへの入力や出力が安全かどうかを判定する、日本語向けセーフガードモデルの改良版を開発したと明らかにした。ガードレール機能を組み込んだ大規模言語モデル(LLM)で、入出力に含まれる有害情報を検知し、生成AIの安全な利用を支援する。
ベースモデルは「gemma-4-E4B-it」に切り替えた。従来モデル「Llama-Ricoh-SafeGuard-20260520」と同等水準の安全性判定性能を保ちながら、モデルを小型化し、より少ない計算資源で使えるようにしたという。オンプレミス環境など、利用できる計算資源に制約のある環境にも導入しやすくなると説明している。
評価では、F1スコアが入力用評価データで0.900(従来モデルは0.891)、出力用評価データで0.942(同0.952)だった。
あわせて、安全性の判定基準を見直した。LLMの性能向上により、従来は安全上の懸念から一律に制限していた内容でも、利用目的や文脈に応じて有用かつ適切な回答ができるケースが増えたためとしている。必要以上に利用を制限せず、安全性を確保しながらLLM本来の有用性を生かす運用を支援するという。
新モデルは、あらかじめ学習した13種類の一般的な有害カテゴリーに加え、ユーザーが用途や運用ポリシーに応じて任意の判定ラベルを追加できる。モデルの追加学習は不要で、業界固有のルールや企業ごとのガイドラインを簡易的に反映できるとしている。
新モデルは、11月から順次、リコージャパンが提供する「RICOH オンプレLLMスターターキット」に標準搭載して提供する。リコーは今後も、安全性と実用性を両立するAI技術の開発と実装を進めていくとしている。
では、小型化と引き換えに、新モデルは何を得て、何を手放したのか。リコーが公表した評価には、他社の2モデルとの比較と、旧モデルとの間に生じた小さな差がある。
【画像解説と記事全文はこちら】安全性判定モデルの性能比較(F1スコア)
安全性判定モデルの性能比較(F1スコア)
(出典:リコー発表、Hugging Faceをもとに作成)
この記事の続き >>
・「同等」とされた精度、入力と出力で分かれた明暗
・海外の比較対象に、リコーはどこまで差をつけたのか
・LlamaからGemma 4へ、ベース替えが意味するもの
この続きは
会員限定(完全無料)です
ここから先は「ビジネス+IT」会員に登録された方のみ、ご覧いただけます。
今すぐビジネス+IT会員に
ご登録ください。
すべて無料!今日から使える、
仕事に役立つ情報満載!
ここでしか見られない
2万本超のオリジナル記事・動画・資料が見放題!
完全無料
登録料・月額料なし、完全無料で使い放題!
トレンドを聞いて学ぶ
年間1000本超の厳選セミナーに参加し放題!
興味関心のみ厳選
トピック(タグ)をフォローして自動収集!
AI・生成AIのおすすめコンテンツ
Googleで見つけやすく
評価する
いいね!でぜひ著者を応援してください
会員(無料)になると、いいね!でマイページに保存できます。
関連タグ