公開
2026年11月01日 08時31分
米OpenAI、米Google、米Microsoftは10月30日(現地時間)、Webサイト運営者がAI学習へのコンテンツ利用に関する意向を複数のAI企業にまとめて伝えられる共通の仕組みに対応する方針をそれぞれ発表した。米Anthropicも実装を進めている。この仕組みは、Anthropicの標準化担当者、ケビン・ケリー氏が同日付で標準化団体IETF(Internet Engineering Task Force)に提出したInternet-Draft(インターネット標準の草案)で提案されている。
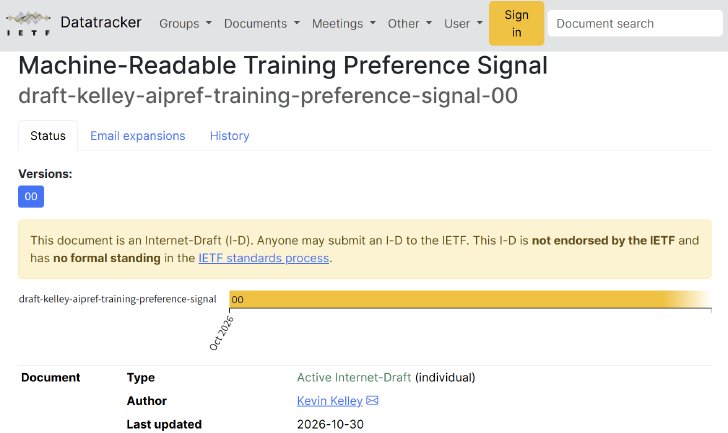
IETFで公開されているドラフト
これまでWebサイト運営者は、AI企業ごとにクローラーを識別し、それぞれに合わせてルールを書き分ける必要があった。新しい仕組みでは、Webサイトへのクローラーのアクセスを制御する「robots.txt」に共通のシグナルを記述することで、複数のAI企業に学習への利用を拒否または許可する意向を一括して伝えられる。IETFのAI Preferences(AIPREF)ワーキンググループでの議論を基にしたもので、OpenAIは、各社が共通のシグナルに対応することで運営者の負担を軽減できるとしている。
ドラフト「Machine-Readable Training Preference Signal」では、robots.txtの「User-Agent」行に「__usage_ai-training」というポリシートークンを指定する。このトークンの下で「Disallow」はAI学習への利用を拒否する意向、「Allow」は許可する意向を示す。例えば「User-Agent: __usage_ai-training」の下に「Disallow: /」と「Allow: /press-kit/」と記述すれば、/press-kit/以下を除く全てのパスについて、学習に使わないよう求める意思表示になる。
この指定は従来のクロール制御とは独立しており、コンテンツのクロール自体を禁止するものではない。クロールを制限したい場合は、引き続き各クローラー向けのルールを使う。共通トークンを指定しなければ、AI学習について特に意向を表明していないと解釈される。新しいディレクティブや文法を導入しないため、既存の解析プログラム(パーサー)の動作には影響しないという。
対象とする「AI学習」は、生成AIモデルの学習済みパラメータを変更するためにコンテンツを利用することと定義されており、生成以外の用途だけに使うモデルの学習は含まない。また、各企業が独自に提供する制御手段を共通シグナルより優先させたり、個別契約に基づいて異なる取り扱いをしたりすることも認めている。なお、このドラフトは個人名義で提出されたもので、現時点ではIETFの標準化プロセス上の正式な地位を持たない。
各社の対応予定時期は異なる。OpenAIは今後数カ月以内の対応を目指し、実装時に詳細を改めて公表するとしている。robots.txtによる既存のクローラー制御は引き続き適用する。同社は他のAI企業にも共通シグナルを尊重するよう呼び掛けた。
Googleは、他のAI企業とともに2027年の対応を目指す。Webサイトが共通シグナルでAI学習への利用を拒否し、かつ同社独自の制御手段「Google-Extended」を明示的に指定していない場合は、Google-Extendedによる利用も拒否したものとして扱う方針だ。Google-Extendedは、同社が2023年から提供しているAI学習向けの制御手段で、共通シグナルの導入後も引き続き利用できる。
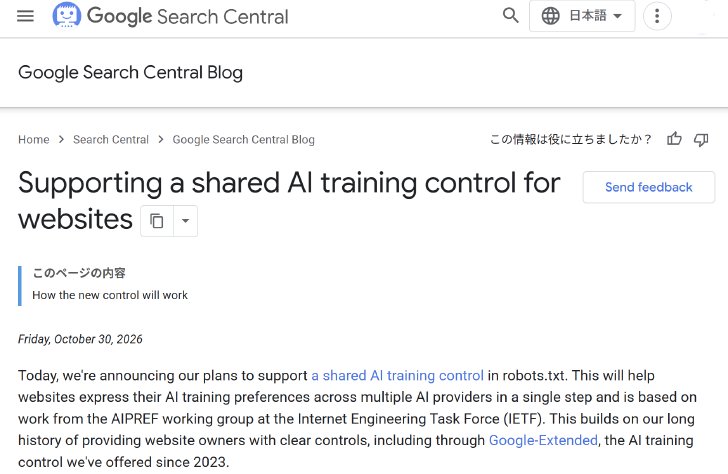
Googleの発表文
Google-Extendedによる利用を明示的に許可したサイトは、GeminiアプリがWebコンテンツを参照して回答を生成する「グラウンディング」の対象となり、回答内で紹介されてクリックを得る可能性があるという。
Googleは今回の提案について、AI学習に関する業界共通の制御を求めてきたパブリッシャーや市民団体、規制当局などの声を反映したものだと説明している。また、robots.txtを機械可読な意思表示の主要な手段として認める、欧州連合(EU)のAI規制法「EU AI Act」に基づく汎用AIモデル提供者向け行動規範とも整合するとしている。
Microsoftは2027年2月1日から、Webページをクロールする際に新しい設定を読み取り、適用を開始する。共通シグナルに加え、AI学習への利用の可否をmetaタグやHTTPヘッダでページ単位でも指定できるようにし、これらをrobots.txtの設定より優先させる。
さらに、AIの回答生成時にWebコンテンツを参照するグラウンディングについても、独自のページ単位の制御を導入する。「Disallow」で利用を拒否できるほか、「DisallowExtended」も指定できる。後者は、CopilotやMicrosoft 365などMicrosoft自身が提供するサービスでの利用は認めながら、同社が外部企業向けに提供する「Web IQ」やMicrosoft FoundryのAPIを通じたグラウンディングでの利用を拒否する設定だ。これらの設定は、Bingの検索結果への掲載には影響しないという。
新設定は従来の「NoArchive」「NoCache」に代わるもので、Microsoftはこれらを利用しているサイトに対し、2027年3月1日までに新しい設定へ移行するよう求めている。グラウンディングの制限を維持する場合は、再クロールまでの経過措置として、Bing Webmaster Toolsでの暫定設定も必要になる。
Anthropicについては、ケリー氏がAIPREFのメーリングリストで、同社が既にドラフトへの対応実装を始めたと報告した。ただし、Anthropicのサービス全体に対応を広げるには時間がかかるとしている。
AI企業によるWebコンテンツの利用を巡っては、パブリッシャーによる訴訟が相次いでいる。米Cloudflareは7月、AI関連のクローラーを「検索」「エージェント」「学習」の用途別に管理できる機能を全顧客に開放した。Googleも6月、AI検索機能へのコンテンツ利用をオプトアウトできるトグルをSearch Consoleで提供すると発表している。
Copyright © ITmedia, Inc. All Rights Reserved.
関連記事