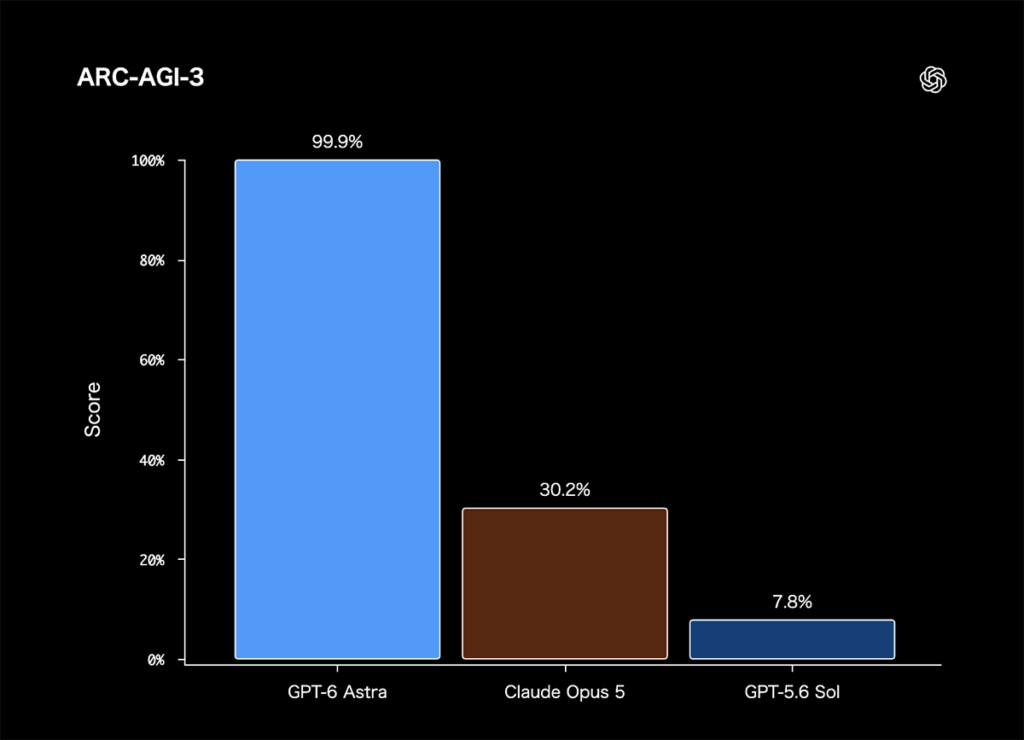
 「ARC-AGI-3」のスコア。GPT-6 Astraは99.9%で、Claude Opus 5の30.2%、GPT-5.6 Solの7.8%を大きく上回った
人間には簡単でAIには難しいゲームで、AGI(汎用人工知能)への距離を測るとされるテスト「ARC-AGI-3」でついに99.9%到達。OpenAIが9月3日(米国時間)に発表した新AIモデル「GPT-6 Astra」は、前モデルが7.8%しか解けなかった難問群をほぼ解き切った。数学の未解決問題でも新記録を打ち立てた。
GPT-6 Astraは、ChatGPTなどの応答を生み出すAIモデルの新世代で、「GPT-5.6 Sol」の上位に立つOpenAIの新たな最上位モデルである。同社は「世界で最も賢く、最も整合したモデル」とうたい、PCの画面操作、コーディング、科学など幅広い分野で最高性能を主張する。安全対策を外した測定では、脆弱性攻撃ベンチマーク「ExploitBench」で100%と、満点に達したテストもある。
実務性能も大きく伸びた。実際の業務ソフトで金融モデリングなどの専門作業を測る「Agents’ Last Exam」では59.3%を記録した。Anthropicの最上位「Claude Opus 5」の55.5%、前モデルGPT-5.6 Solの53.6%を上回る数値だ。PCを自律操作する「OSWorld 2.0」(オフライン版)では、GPT-5.6 Solが1タスク約75分で65.7%のところ、約40分で72.6%に達した。
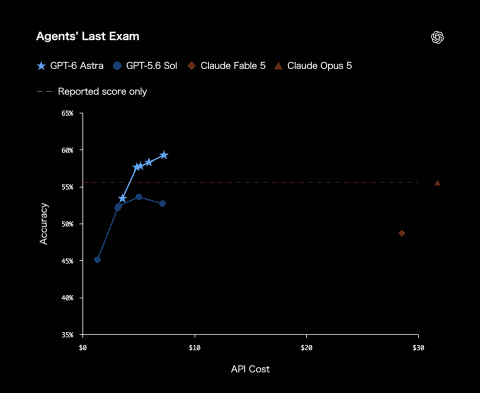 実務ソフトでの専門作業を測る「Agents’ Last Exam」の正答率とAPIコスト。GPT-6 Astraは59.3%で、Claude Opus 5の55.5%、GPT-5.6 Solの53.6%を上回った
指示が曖昧なときの振る舞いも変わった。結果を左右する不足情報だけを利用者に質問し、回答を待つ間も、回答に左右されない作業を先に進める。
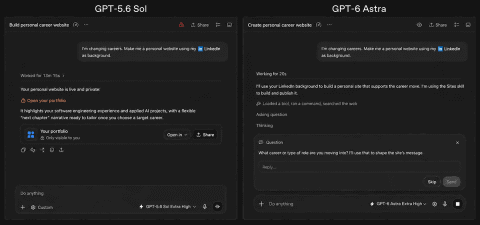 GPT-5.6 Sol(左)とGPT-6 Astra(右)に個人サイト作成を頼んだ画面の比較。Astraは作業を進めながら、結果を左右する不足情報だけを利用者に質問してくる
数学では、素数の間隔に関する2つの未解決問題を前進させた。無限に現れる素数のペアの間隔の上界を、従来の240から186に縮める証明に貢献した。80年以上更新されていなかった大きな素数間隔の評価式も改良している。
ただし、すべてのAIモデルに圧勝しているわけではない。ツール利用込みの総合試験「Humanity’s Last Exam」は57.2%で、「Claude Fable 5.1」の65.0%に7.8ポイント差をつけられた。
9月3日に一部の組織を対象に提供を開始し、数日かけてChatGPTのPlus、Pro、Business、Enterprise各プランとAPI、AWS(Amazon Bedrock)に広がる。API料金は100万トークンあたり入力10ドル(約1,560円、1ドル=約156円換算)、出力50ドル(約7,800円)だ。
一方で、Astraはサイバー攻撃能力が高すぎ、OpenAIの安全基準で初めて最高危険度「Critical」と判定された。このため提供版は、攻撃コードの作成など高度なサイバー系タスクを拒否する。審査制の「OpenAI Daybreak」を通じて防御用途向けに制限を緩める計画だが、その条件の詳細は9月4日時点で公開されていない。