こんにちは。SB Intuitionsで画像生成モデルの研究開発に取り組んでいるHwangです。
SB Intuitionsでは、これまで日本語に強い大規模言語モデルやVision-Language Modelの研究開発を進めてきました。
日本語には、語順の自由度、主語や目的語の省略、複雑な修飾関係、文脈に依存した表現など、モデルにとって扱いが難しい特徴があります。そのため、日本語環境で生成AIを実用的に活用するには、英語を中心に開発されたモデルをそのまま利用するだけでなく、日本語の意味構造やニュアンスを適切に扱うための基盤技術が重要になります。
今回、私たちはこの取り組みを画像生成領域へと広げ、自社で画像生成基盤モデル「Sarashina Image 2.6B」を開発しました。
Sarashina Image 2.6Bは、日本語および英語のテキストプロンプトから高解像度画像を生成するモデルです。既存の画像生成モデルをベースとしたファインチューニングではなく、画像生成の中核を担うDiffusion Transformer (DiT) [1] をフルスクラッチで訓練することにより開発されました。学習データは、自社購入の大規模ストックフォトを中核に、ライセンスや利用規約を遵守して集められた様々なオープンデータセットを組み合わせることで構築されました。
また、Text Encoderには、SB Intuitionsが開発したSarashina2.2-Vision-3Bを採用しました。日本語プロンプトに含まれる複雑な意味構造や細かなニュアンスを捉え、生成画像に反映することを目指しています。
本記事では、Sarashina Image 2.6Bの開発背景、モデル構成、学習手法、評価結果、生成例、実用化に向けた課題と今後の展開について紹介します。
なぜ画像生成モデルを自社で開発するのか
近年、画像生成モデルは急速に発展しています。短いテキストプロンプトから高品質な画像を生成できるモデルが数多く登場し、広告、デザイン、教育、エンターテインメント、EC、業務支援など、さまざまな領域での活用が期待されています。
一方、画像生成AIを日本語環境や企業の業務で活用するには、生成画像の美しさだけでは解決できない課題があります。
一つ目は、日本語プロンプトへの対応です。
多くの画像生成モデルは英語プロンプトに対して高い性能を発揮しますが、日本語で自然に記述された指示では、条件の一部が抜け落ちたり、長い修飾関係を誤って解釈したりすることがあります。
画像生成モデルには、プロンプトに含まれる対象物を認識するだけでなく、その属性、背景、空間的な関係、全体の雰囲気までを統合し、1枚の画像として整合的に表現する能力が求められます。特に日本語では、主語や目的語の省略、柔軟な語順、文脈に依存する表現などを考慮しながら、文全体の意味構造を捉える必要があります。
二つ目は、学習データを含む開発プロセスを適切に管理する難しさです。
画像生成モデルを企業向けサービスとして提供するには、生成品質だけでなく、学習データの利用条件や権利面、安全性、不適切な生成の抑制についても継続的に確認する必要があります。外部の事前学習済み画像生成モデルだけに依存する場合、どのようなデータや方針に基づいてモデルが構築されたかを、サービス提供者が十分に把握・制御できないことがあります。
そこでSarashina Image 2.6Bでは、データの利用条件や権利面、安全性を考慮しながら学習データを構成し、画像生成モデル本体をスクラッチから学習しました。モデル設計からデータ構築、学習、評価までを一貫して自社で行うことで、日本語への対応力だけでなく、将来の企業利用に必要な透明性と制御可能性を備えた技術基盤の構築を目指しています。
Sarashina Image 2.6Bは、SB Intuitionsがこれまで培ってきた日本語処理、マルチモーダル理解、大規模モデル開発の知見を画像生成へと広げ、より安心して活用できる画像生成基盤を実現するための取り組みです。
Sarashina Image 2.6Bの概要
Sarashina Image 2.6Bは、日本語および英語のテキストプロンプトから高解像度画像を生成する画像生成基盤モデルです。画像生成の中核には、26億パラメータ規模のDiTを採用し、圧縮された画像表現である潜在空間上で生成処理を行います。
入力されたプロンプトは、SB Intuitionsが開発したSarashina2.2-Vision-3Bによってトークン単位のテキスト表現に変換されます。DiTは、このテキスト表現、ノイズを含む画像潜在表現、生成過程の時刻情報を受け取り、各時刻における速度場を予測します。生成された潜在表現は、最終的にVAE Decoderを通じてピクセル空間へ復元されます。
画像生成を担うDiTは、既存の画像生成モデルの重みを利用せず、スクラッチから学習しました。また、日本語と英語のキャプションを含む学習データの構成、学習パイプライン、最適化手法、評価環境を自社で構築しています。
これにより、日本語プロンプトに含まれる対象物や属性だけでなく、修飾関係、背景、空間的な関係、スタイルや雰囲気を画像に反映する能力の獲得を目指しました。次節では、Text Encoder、DiT、VAE Decoderからなるモデル構成について、より詳しく説明します。
モデル構成
Sarashina Image 2.6Bは、主に次の3つのコンポーネントから構成されています。
テキストを理解するText Encoder
潜在空間上で画像を生成するDiffusion Transformer
潜在表現を高解像度画像へ変換するVAE Decoder
これら3つのコンポーネントの関係を図1に示します。
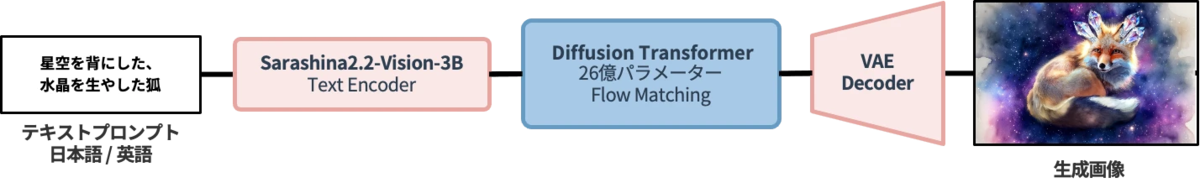
図1:Sarashina Image 2.6Bの全体構成。日本語または英語のテキストプロンプトを入力とし、Text Encoder、DiT、VAE Decoderを通じて画像を生成する。
Text Encoder:Sarashina2.2-Vision-3B
画像生成において、Text Encoderは、プロンプトの内容を画像生成モデルが扱える表現へ変換する役割を持ちます。
同じ単語が含まれるプロンプトであっても、対象物同士の関係、修飾の範囲、文脈、表現のニュアンスが異なれば、生成すべき画像も変化します。特に日本語では、主語や目的語が省略されることがあります。また、修飾語が長く続く文章や、語順だけでは関係性を判断しにくい表現も少なくありません。
Sarashina Image 2.6Bでは、Sarashina2.2-Vision-3Bを用いて、こうしたプロンプトをトークン単位の意味表現に変換します。得られたテキスト表現は、後段のDiTへ入力され、生成画像の構図や内容を制御する条件として利用されます。対象物、属性、背景、空間関係、雰囲気など、プロンプトに含まれる複数の条件を画像に反映するための基礎となります。
Diffusion Transformer:26億パラメータ
画像生成の中核には、26億パラメータ規模のDiTを採用しています。
Transformerは、文章中の単語同士の関係を扱うために発展してきたアーキテクチャですが、近年では画像生成においても広く利用されています。多数のトークン間の関係を同時に扱えるため、画像全体の構造や、離れた領域同士の依存関係を表現しやすいという特徴があります。
Sarashina Image 2.6Bでは、Lumina-Image 2.0で提案された Unified Next-DiTアーキテクチャ [2] を採用しています。このアーキテクチャでは、テキストトークンと画像の潜在トークンを1つの系列として扱い、同一のTransformer内で統合的に処理します。
画像トークンは、画像の各領域に対応する情報を持ちます。一方、テキストトークンは、プロンプトに含まれる対象物、属性、関係性、スタイルなどの情報を持ちます。
両者がAttention層を通じて相互作用することで、モデルは「何を描くか」だけでなく、「どのような属性を持つか」「どこに配置するか」「どのような背景や雰囲気にするか」といった条件を画像全体に反映します。
また、テキストの系列位置と画像の縦方向・横方向の位置を扱うため、複数の軸からなる位置表現を導入しています。これにより、異なる長さのプロンプトや、多様な解像度・アスペクト比の画像を同じモデルで処理できます。
大規模学習における数値的な安定性を確保するため、Transformerブロックの正規化手法やAttention計算にも工夫を取り入れています。また、Triton [3] を活用することで、VRAM使用量の低減、処理速度の大幅な改善、および数値誤差の抑制を同時に実現しました。
モデルは、ノイズを含んだ画像潜在表現、生成過程の時刻情報、プロンプトから得られたテキスト表現を入力として受け取ります。そして、ノイズを含む潜在表現を画像に対応する潜在表現へ近づけるための更新方向を予測します。本モデルにおけるDiTの構成を図2に示します。
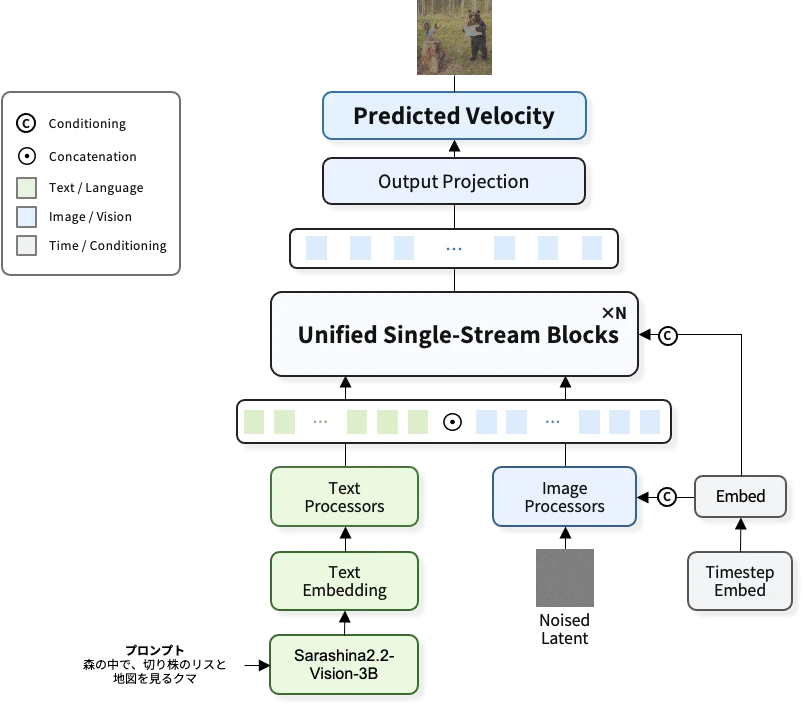
図2:Sarashina Image 2.6BのDiT内部の概略図。テキスト表現と画像潜在表現を統合的に処理し、時刻情報による条件付けを受けながら生成を進める。
この処理を繰り返すことで、図3に示すように、初期ノイズからプロンプトに沿った画像構造が徐々に形成されます。
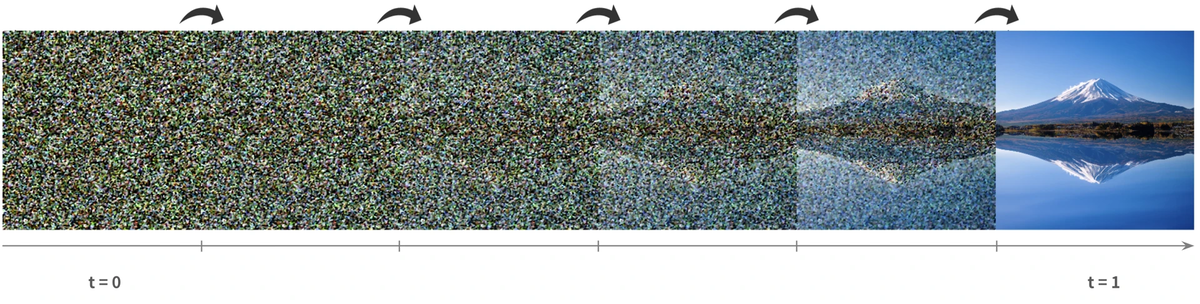
図3:初期ノイズから徐々に画像が生成されていく様子。潜在空間上の変化をVAE Decoderでピクセル空間に射影することでステップごとに可視化。
潜在表現から高解像度画像への復元
DiTによって生成された潜在表現は、VAE Decoderによってピクセル空間へ変換されます。
画像を潜在空間に圧縮し、その空間上で生成処理を行う枠組みは、Latent Diffusion Models (LDM) [4] で提案されました。高解像度画像をピクセル空間上で直接生成すると、計算量とメモリ使用量が非常に大きくなります。そのため、Sarashina Image 2.6Bでは、画像を圧縮した潜在空間上で主な生成処理を行います。
潜在空間では、画像の細かなピクセルを直接扱う代わりに、構図、形状、色、質感などを圧縮された表現として扱えます。
生成された潜在表現を高い復元性能を持つVAE Decoderで復元することにより、多様なアスペクト比に対応しながら、1メガピクセル級の高解像度画像を出力します。
画像生成では、潜在空間における意味構造と、ピクセル空間への復元品質の両方が重要です。
潜在表現がプロンプトに沿っていても、復元時に細部が崩れれば最終的な品質は低下します。一方、VAE Decoderの復元性能が高くても、潜在空間上の構図や意味関係が不安定であれば、指示に沿った画像にはなりません。
Sarashina Image 2.6Bでは、テキスト理解、潜在空間上の画像生成、高解像度画像への復元を、一連の生成パイプラインとして構成しています。
Flow Matchingによる生成プロセスの学習
Sarashina Image 2.6Bでは、生成プロセスの学習にFlow Matching [5] を用いています。Flow Matchingは、ノイズ分布と画像のデータ分布を結ぶベクトル場を回帰によって学習する手法です。
学習時には、画像の潜在表現とノイズを時刻に応じた比率で混合し、中間的な潜在表現を作ります。モデルは、この潜在表現、時刻情報、テキスト条件を入力として受け取り、各時刻における速度場 (Velocity) を予測します。
予測した速度場と目標速度場の差を損失として最小化することで、モデルはノイズから画像潜在表現へ至る生成経路を学習します。
サンプリング時には、ランダムノイズから出発し、モデルが予測する速度場ベクトルに沿って潜在表現を段階的に更新します。これにより、プロンプトに含まれる内容や構図が徐々に形成され、最終的な画像潜在表現へ変換されます。
Sarashina Image 2.6Bでは、このFlow Matchingを DiTと組み合わせて学習しています。学習時の処理概要を図4に示します。
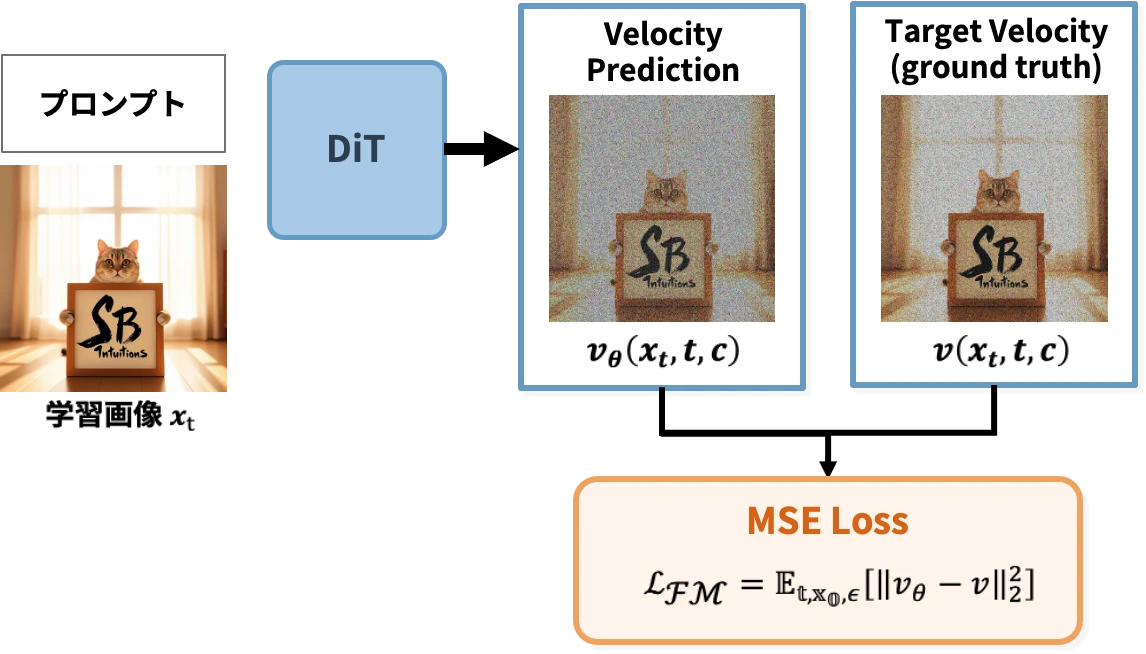
図4:Flow Matchingによる学習の概略。ノイズを含む潜在表現とテキスト条件から速度場を予測し、目標速度場との誤差を最小化する。
Progressive Pretraining:256×256から1024×1024へ
高解像度の画像生成モデルを最初から学習する場合、計算量とメモリ使用量が大きくなるうえ、学習の安定性も確保しにくくなります。
高解像度画像には、画像全体の構図、対象物同士の関係、局所的な質感、細かな装飾、背景情報など、多くの要素が同時に含まれます。また、画像トークン数が増加することで、Transformerの計算コストも大きくなります。
そこで、Sarashina Image 2.6Bでは、学習解像度を256×256相当から1024×1024相当へ引き上げるProgressive Pretrainingを採用しました。
低解像度段階では、比較的少ない計算量で、対象物、構図、色、スタイル、テキストと画像の基本的な対応関係など、画像生成に必要な基礎能力を効率よく学習します。その後、高解像度段階へ移行し、複雑な構図や局所的な形状、質感、装飾、光などに関する表現力を高めます。
高解像度段階では、単純に低解像度画像に細部を付け加えるだけではありません。画像全体の構造やテキストとの対応関係も引き続き学習しながら、より多くの画像トークンを安定して扱えるように最適化します。
このように、学習解像度を段階的に高めることで、計算効率と生成品質の両立を目指しました。
Reinforcement Learningによる生成品質の改善
Flow Matchingによる事前学習では、モデルは大規模な画像・テキストデータの分布を学習します。
しかし、データ分布を再現できることと、ユーザーが求める画像を安定して生成できることは必ずしも同じではありません。
たとえば、視覚的には自然な画像であっても、プロンプトで指定された対象物や属性が欠けている場合があります。反対に、プロンプト内の要素が含まれていても、構図や質感が不自然で、実際の用途では使いにくい画像になることもあります。
そこで、Sarashina Image 2.6Bでは、事前学習に加えて、報酬モデル (Reward Model) を用いた選好最適化を行いました。具体的には、Group Relative Policy Optimization (GRPO) [6] を Flow Matchingモデルに適用したFlow-GRPO [7] を用い、同一のプロンプトから複数の画像を生成して、それぞれを報酬モデルで評価します。各画像の報酬をグループ内で相対化し、より高い報酬を得た画像が生成されやすくなるようにモデルを更新します。これにより、使用する報酬モデルや学習目的に応じて、プロンプト追従性や視覚品質といった評価軸に沿ってモデルを最適化できます。この選好最適化の流れを図5に示します。
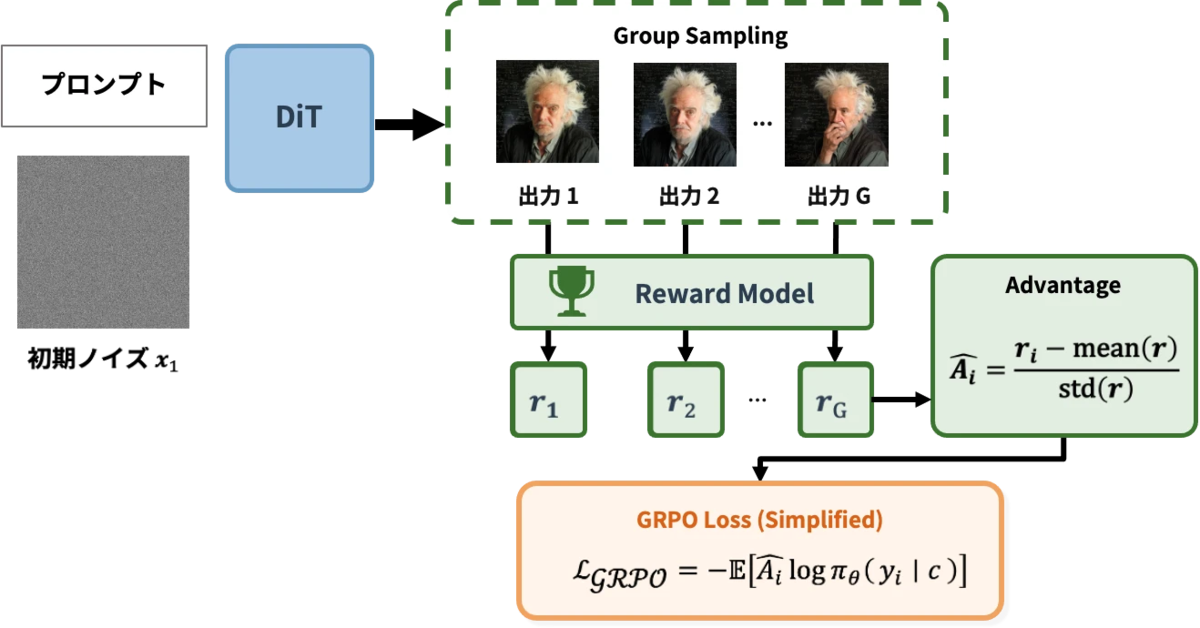
図5:GRPOによる選好最適化の概略。同一のプロンプトから複数の画像を生成し、報酬モデルによる相対評価を用いてモデルを更新する。
一方で、報酬モデルが評価できる範囲には限界があります。特定の評価指標だけを過度に最適化すると、画像の多様性が低下したり、意図しない視覚的特徴が強調されたりする可能性もあります。
そのため、選好最適化では、報酬の構成、モデルの更新量、生成画像の多様性、事前学習で獲得した能力の維持状況を確認しながら、慎重に学習を進める必要があります。
Sarashina Image 2.6Bでは、Flow Matchingによる基礎的な生成能力と、GRPOによる選好最適化を組み合わせることで、より実用性の高い生成性能を目指しました。GRPO適用前後の代表的な生成結果を図6に示します。
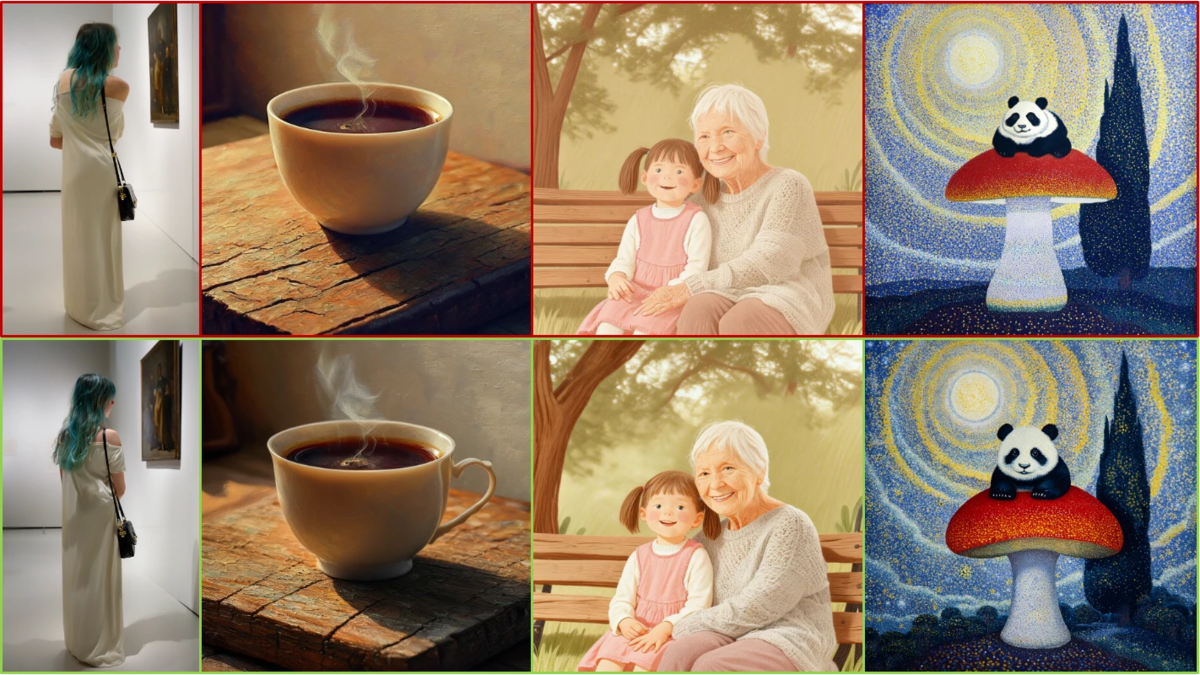
図6:GRPO適用前後の画像生成結果の比較。上段 (赤枠) が適用前、下段 (緑枠) が適用後を示す。GRPOを適用した下段の方が、細部の描写や構造がより自然になり、全体的な画像品質が向上していることが確認できる。
評価設定
Sarashina Image 2.6Bの性能を多面的に確認するため、複数の画像生成モデルとの比較評価を行いました。
画像生成モデルの性能は、画像の品質だけでなく、プロンプトへの追従性、文字生成、スタイル表現、複雑な条件の理解など、複数の観点から評価する必要があります。そこで本評価では、以下の2つのベンチマークを使用しました。
OneIG-Bench [8]:Alignment、Text Rendering、Reasoning、Style、Diversityの5つの観点から、画像生成モデルの総合的な能力を評価するベンチマークです。
UniGenBench English Long [9]:複数の対象物、属性、数量、空間関係、スタイルなどを含む長い英語プロンプトに対して、各条件をどの程度正確に画像に反映できるかを評価します。
OneIG-Benchでは公式の英語プロンプトに加えて、それらを日本語に翻訳した評価セットも用意し、英語と日本語での生成性能を比較しました。
各モデルについて可能な限り生成条件をそろえ、各プロンプトにつき4枚の画像を生成したうえで、同一の評価手順でスコアを算出しています。ただし、API経由で提供されるモデルなど、利用可能な生成設定が異なるモデルも含まれるため、本結果はモデルの能力を厳密に順位付けするものではなく、一定の条件下における比較結果として示しています。本記事では各ベンチマークの評価指標を平均した値をOverall Scoreとして用います。
評価結果
2つのベンチマークにおける比較結果を図7に示します。
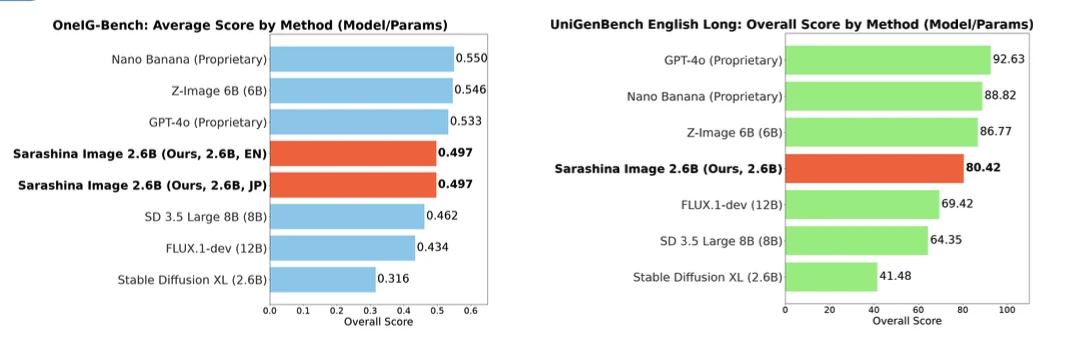
図7:OneIG-BenchおよびUniGenBench English Longにおける比較結果。Sarashina Image 2.6Bは、複数の既存モデルに対して競争力のある結果を示した。
OneIG-Bench
Sarashina Image 2.6Bは、英語プロンプトと、それを日本語に翻訳した評価セットの双方において、丸め後の総合スコアで0.497を記録しました。
この評価条件では、Stable Diffusion XL、FLUX.1-dev、Stable Diffusion 3.5 Large 8Bを上回る結果となりました。26億パラメータ規模でありながら、より大規模なモデルを含む複数の既存モデルに対して、一定の競争力を示しています。
また、英語と日本語で同等の総合スコアが得られたことから、Sarashina2.2-Vision-3Bの導入や日英両方のキャプションを用いた学習が言語間の性能差の縮小に寄与した可能性があります。
ただし、総合スコアが同等であっても、個別のプロンプトや評価カテゴリにおける挙動が完全に同じとは限りません。日本語特有の表現を含めた、より詳細な分析は今後の課題です。
UniGenBench English Long
Sarashina Image 2.6Bは、UniGenBench English Longにおいて80.42のOverall Scoreを記録しました。
この評価条件では、FLUX.1-dev、Stable Diffusion 3.5 Large 8B、Stable Diffusion XLを上回る結果となりました。
UniGenBench English Longでは、1つのプロンプトに含まれる複数の対象物や属性、数量、位置関係などを同時に満たす必要があります。今回の評価では、長く複雑なプロンプトに対しても、高いプロンプト追従性能を示しました。
一方で、評価上位のモデルとの差は残っており、特に属性の取り違え、複数の対象物の配置、細かな数量指定、左右・前後などの空間関係には、さらなる改善の余地があります。
画像編集への拡張
テキストからの画像生成に加えて、既存の写真やデザイン素材を自然言語で編集できるようになれば、実際の制作フローで活用できる場面はさらに広がります。対象物の追加・削除、背景の変更、スタイル変換、表情や属性の調整など、用途に応じて画像の一部を柔軟に変更したいという高いニーズがあります。自然言語による指示に基づく画像編集は、InstructPix2Pix [10] などで研究されてきました。また、画像生成と編集を単一のモデルで扱う構成として、OmniGen [11] などが提案されています。
そこで私たちは、Sarashina Image 2.6Bと同じDiTのアーキテクチャをベースに、参照画像と編集指示を入力とするInstruction-based Image Editingへの拡張を進めています。あらかじめ編集領域をマスクで指定するInpaintingとは異なり、画像全体の内容と編集指示の関係を捉え、指定された変更を反映しながら、編集対象以外の内容や構図をできるだけ維持することを目指しています。
モデルは、1枚または複数枚の参照画像と自然言語による編集指示を受け取り、編集後の画像を生成します。局所的な修正から画像全体の変換、さらに複数の参照画像を用いた合成まで、幅広い編集タスクを統一的に扱えるよう開発を進めています。画像編集モデルの全体構成を図8に示します。
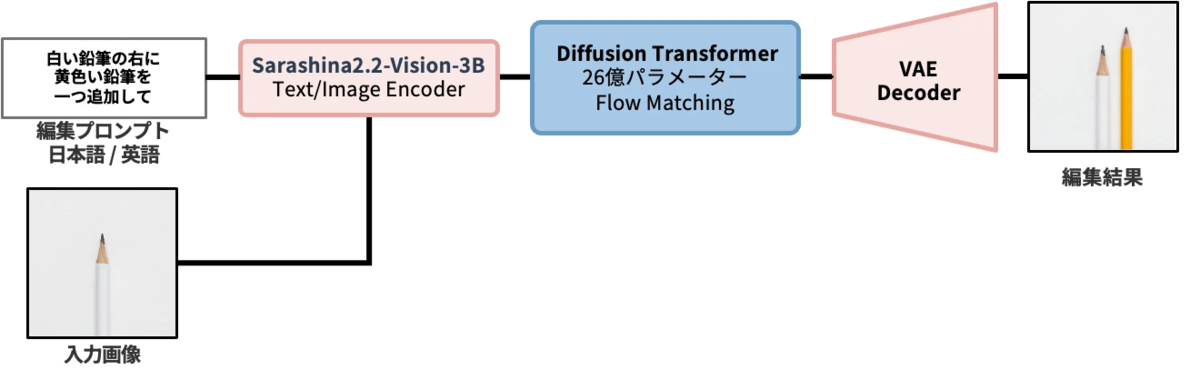
図8:画像編集モデルの処理概要。参照画像と自然言語による編集指示を条件として、DiTが編集後画像の潜在表現を生成し、画像デコーダーによってピクセル空間へ復元する。
参照画像と編集指示はVision-Language Modelで処理され、画像の内容と編集意図を捉えたマルチモーダルな条件表現に変換されます。同時に、参照画像をVAEによって潜在空間へ圧縮し、ノイズを加えない条件トークンとしてDiTに入力します。モデル内部では、テキスト条件トークン、参照画像の潜在トークン、そして編集後画像に対応するノイズ付き潜在トークンを1つの系列として統合的に処理します。
参照画像に対応する潜在トークンには、クリーンな画像を表す固定の時刻条件を与え、生成対象となる潜在トークンのみをノイズから編集後画像の潜在表現へ変換します。複数の参照画像を入力する場合は、それぞれの潜在トークンを系列上で連結し、同じAttention機構の中で処理します。これにより、たとえば人物と背景を別々の画像から参照し、それぞれの要素を1枚の画像内で自然に組み合わせることができます。
編集モデルの学習には、画像生成モデルと同様にFlow Matchingを用います。参照画像、編集後画像、編集指示のトリプレットからなる編集データで事前学習した後、特定の編集タスクに重点を置いた追加学習を行っています。また推論時には、必要に応じて別のVision-Language Modelを用い、短いユーザー指示をより具体的な編集プロンプトへ展開します。
このように、画像生成の枠組みに参照画像による条件付けとマルチモーダルな指示理解を組み込むことで、画像生成と画像編集を共通の技術基盤上で扱えるモデルを構築しています。
生成・編集例
本節では、Sarashina Image 2.6Bによる画像生成例と、同モデルをベースとした画像編集モデルによる編集例をまとめて紹介します。
テキストからの画像生成
Sarashina Image 2.6Bのモデル構成や評価結果について紹介してきました。ここでは、実際の生成例をいくつか紹介します。
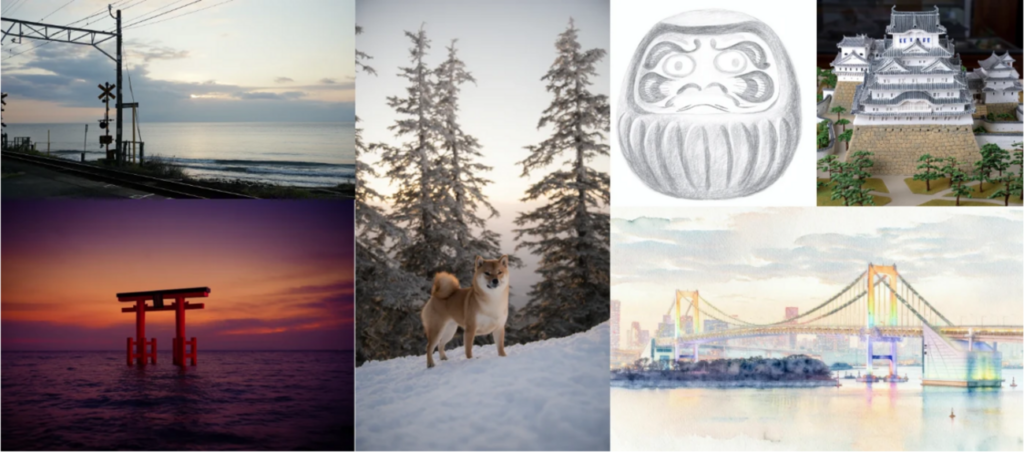
Sarashina Image 2.6Bでは、写実的な写真表現から、鉛筆画や水彩画といったイラスト表現まで、さまざまなスタイルの画像を生成できます。また、日本の風景や文化に関連するモチーフについても、日本語で自然に記述されたプロンプトに対応できるよう学習しています。
図9では、海沿いを走る鉄道、日本の雪景色と柴犬、だるまの鉛筆画、日本の城、海の中の鳥居、都市の橋を描いた水彩画など、多様な題材と表現スタイルによる生成例を紹介します。
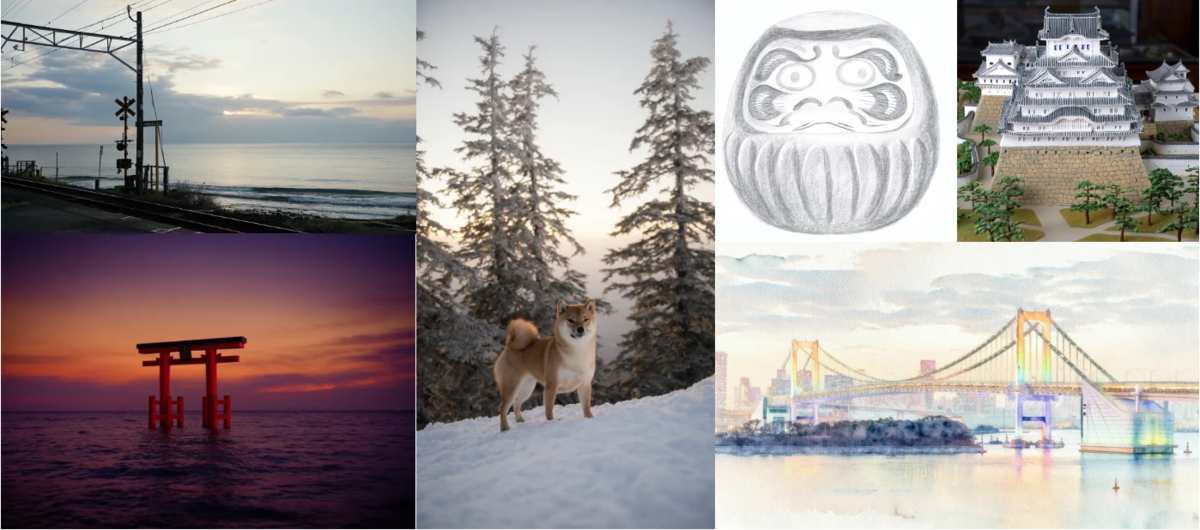
図9:Sarashina Image 2.6Bによる画像生成例。写真調の風景から、鉛筆画、水彩画、日本文化に関連するモチーフまで、さまざまな題材・スタイルの生成が可能。
画像生成では、単にプロンプトに含まれる物体を描くだけでなく、背景、構図、光の状態、画材や表現スタイルといった複数の要素を組み合わせる必要があります。Sarashina Image 2.6Bでは、こうした条件を日本語や英語の自然な文章として指定し、それらを一枚の画像に整合的に反映することを目指しています。
特に、日本の風景や文化を自然に描写できることは、日本語環境で画像生成AIを利用するうえで重要です。今後も、日本語特有の表現や、日本国内の文化・風景・デザインに関する理解をさらに高めることで、日本語環境でより自然に利用できる画像生成基盤モデルを目指していきます。
自然言語による画像編集
ここでは、開発中の画像編集モデルによる代表的な編集例を紹介します。
画像編集では、自然言語による指示に沿って画像を変更するだけでなく、編集する必要のない領域や、元画像の構図・被写体の特徴をできるだけ維持することも重要です。 Sarashina Image 2.6Bをベースとした画像編集モデルでは、局所的な変更から画像全体に及ぶ変換まで、さまざまな編集への対応を進めています。
図10では、写真からイラストへのスタイル変換、人物のポーズ変更、風景の季節や時間帯の変更など、異なる種類の編集例を示します。たとえば、富士山や日本庭園では元画像の構図を維持しながら表現スタイルや季節を変更し、都市景観や石灯籠の例では、主要な被写体を維持しながら時間帯や天候、照明などを変化させています。
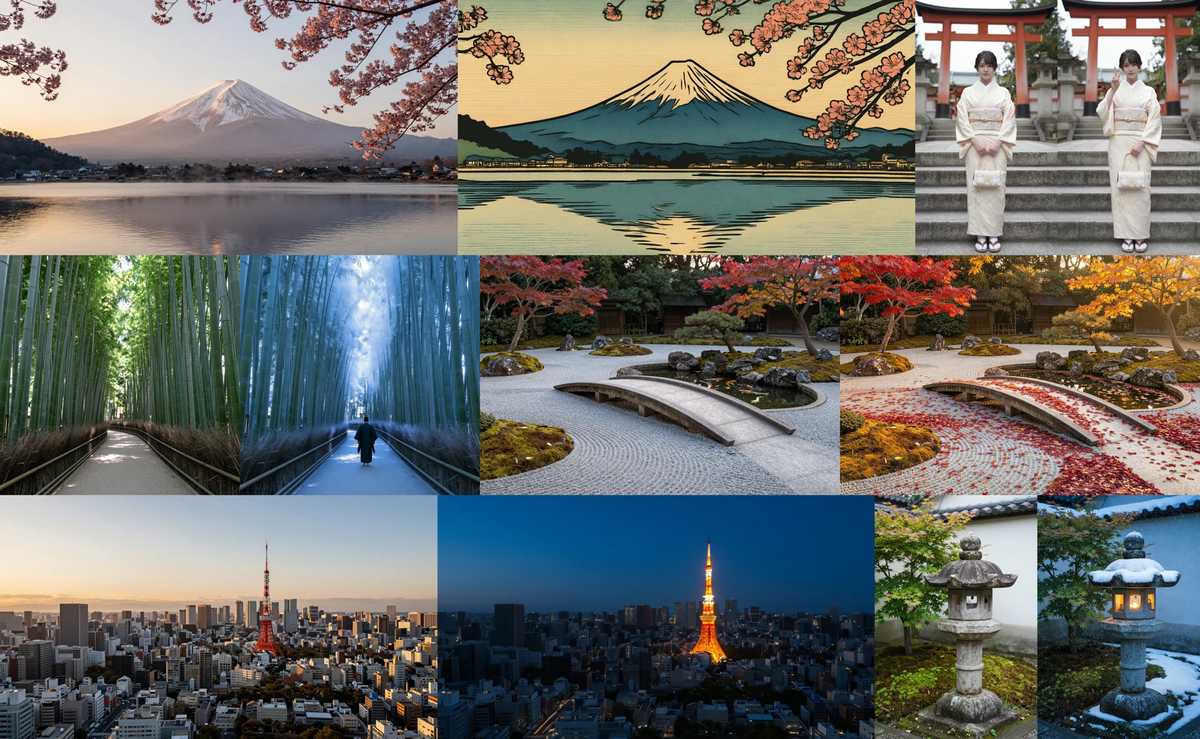
図10:Sarashina Image 2.6Bをベースとした画像編集モデルによる画像編集例。各ペアの左側が入力画像、右側が編集結果を示す。スタイル変換、人物のポーズ変更、季節・時間帯・天候の変更など、自然言語によるさまざまな編集が可能。
これらの例では、指示された内容を反映しながら、元画像の主要な構図や被写体を維持しています。画像編集には、編集指示への追従性と編集対象以外の領域を安定して保つ一貫性の両方が求められます。
実用化に向けた課題と今後の展開
Sarashina Image 2.6Bは、当社初の画像生成基盤モデルとして、一定の性能を示しました。一方、実際のクリエイティブ制作や企業利用に向けては、引き続き改善すべき課題があります。
長いプロンプトや複数の対象物を含む場面では、指定された属性が別の対象に誤って付与されたり、数量や位置関係が正しく反映されなかったりする場合があります。また、人物の手指、反復模様、細かな装飾など、局所的な構造にも不自然さが残ることがあります。
プロンプトへの追従性だけでなく、画像の視覚品質にもさらなる改善が必要です。構図の安定性、色彩の調和、光や陰影の表現、質感の精細さ、スタイルの一貫性などは、生成画像の完成度を大きく左右します。特に広告やデザインなどの実用領域では、単に破綻のない画像を生成するだけでなく、利用者がそのまま活用できる水準の視覚的な魅力と仕上がりが求められます。
広告、ポスター、バナー、商品紹介画像などの制作では、こうした審美性に加えて、文字の正確性、情報の配置、余白、視線誘導などを含むレイアウト制御も重要になります。今後は、日本語を含む文字生成やデザイン用途に適した構図の生成を強化するとともに、既存画像の一部修正、対象物の追加・削除、背景変更など、画像編集機能のさらなる高度化も進めていきます。
企業が継続的に利用できるサービスを実現するためには、生成品質だけでなく、安全性、不適切な生成の抑制、学習データの利用条件や権利面の管理、モデル更新時の包括的な評価も欠かせません。
今後は、プロンプト追従性、審美性、文字・レイアウト生成、画像編集、安全性などの評価を拡充し、平均スコアだけでは捉えにくいロングテールの失敗事例についても、継続的に分析します。これらの改善を通じて、画像生成・編集・デザイン支援を組み合わせたB2B向けAPIサービスへの展開を目指します。
おわりに
SB Intuitionsでは、日本語に強い生成AIを社会実装するため、言語、画像、マルチモーダル領域を横断した基盤モデル開発を進めています。
Sarashina Image 2.6Bは、その取り組みを画像生成へと広げる第一歩です。
今後も、モデル性能の向上に加え、安全性の強化、評価基盤とデータの整備、サービス化まで含めた研究開発を進め、その成果や技術的知見を本ブログで紹介していきます。
開発メンバー
Sarashina Image 2.6Bは、以下のメンバーによって開発されました (敬称略)。
Ryohei Shimizu
Kota Izumi
Dong-Hyun Hwang
Chen Zhu
Vaibhav Singh
Shiqi Yang (Project Lead)
モデルの設計・学習、データ構築、評価をはじめ、本プロジェクトに貢献したすべてのメンバーに感謝します。
参考文献
[1] William Peebles and Saining Xie, “Scalable Diffusion Models with Transformers,” ICCV, 2023. arXiv:2212.09748
[2] Qi Qin et al., “Lumina-Image 2.0: A Unified and Efficient Image Generative Framework,” arXiv:2503.21758, 2025
[3] OpenAI, “Introducing Triton: Open-source GPU programming for neural networks,” OpenAI, 2021
[4] Robin Rombach et al., “High-Resolution Image Synthesis with Latent Diffusion Models,” CVPR, 2022. arXiv:2112.10752
[5] Yaron Lipman et al., “Flow Matching for Generative Modeling,” ICLR, 2023. arXiv:2210.02747
[6] Zhihong Shao et al., “DeepSeekMath: Pushing the Limits of Mathematical Reasoning in Open Language Models,” arXiv:2402.03300, 2024
[7] Jie Liu et al., “Flow-GRPO: Training Flow Matching Models via Online RL,” arXiv:2505.05470, 2025
[8] Jingjing Chang et al., “OneIG-Bench: Omni-dimensional Nuanced Evaluation for Image Generation,” arXiv:2506.07977, 2025
[9] Yibin Wang et al., “UniGenBench++: A Unified Semantic Evaluation Benchmark for Text-to-Image Generation,” arXiv:2510.18701, 2025
[10] Tim Brooks, Aleksander Holynski, and Alexei A. Efros, “InstructPix2Pix: Learning to Follow Image Editing Instructions,” CVPR, 2023. arXiv:2211.09800
[11] Shitao Xiao et al., “OmniGen: Unified Image Generation,” arXiv:2409.11340, 2024