AIの研究機関は、新しいモデルをリリースする際、コーディングやコンピューター操作といった分野で競合他社を上回る優れた能力を示そうとして、目覚ましいベンチマークのスコアをアピールすることが多い。しかし、そうしたベンチマークは指数関数的に向上するモデルによって容易に更新される上、実際の性能よりもマーケティングが強調される傾向があるため、AIに何ができるかを測る信頼性の高い尺度とは必ずしもいえない。
「人類最後の試験」のようなベンチマークは、より現実的な環境でモデルに課題を与えることでこの問題に対処しようとしている。だが、モデルは課題を達成するために依然として抜け道を見つけ出している。Hugging Faceで起きた事件は、まさにその好例といえる。
そこで、非営利団体のAI安全性センター(CAIS)は「CheatBench」(チートベンチマーク)を開発した。その名称が示す通り、ほぼ全てのフロンティアモデルで不正行為が確認された。
CAISの調査結果
AIモデルは、課題を正確かつ迅速に達成することで報酬を得る仕組みになっている。しかし、知識やツールが不足していると、モデルは「隠された答えを探す」「他のエージェントの提出物をコピーする」「採点方法を操作する」といった手法に走り、研究者が「報酬ゲーム」と呼ぶ不当な行動を選択するようインセンティブが働く。CAISは、誠実な作業が困難な場合にAIエージェントがこうした“近道”に走る頻度を測定すべく、CheatBenchを開発したと説明している。
CAISは、OpenAIの「Codex」に搭載された「GPT-6 Astra」、Anthropicの「Claude Code」に搭載された「Fable 5.1」、Metaが発表した「Muse Code」に搭載の「Muse Spark 1.3」など、最新かつ高い評価を得ているモデルで動作する複数のエージェントを対象にテストを実施した。検証は、執筆、専門的な作業、数学的研究、コーディングなど10のカテゴリーにわたって行われた。タスクのファイル空間内に潜ませた「ハニーポット(おとり)」となる手がかりを活用し、テストでは許容される参照行為と不正行為を区別した。CheatBenchでは、成功したかどうかにかかわらず、エージェントが不正を試みた全ての行動を集計している。
研究者らは、各設定において誠実な作業の基準を定めた上で、発見可能な不正の機会を用意し、一線を越える行動を定義したと説明している。
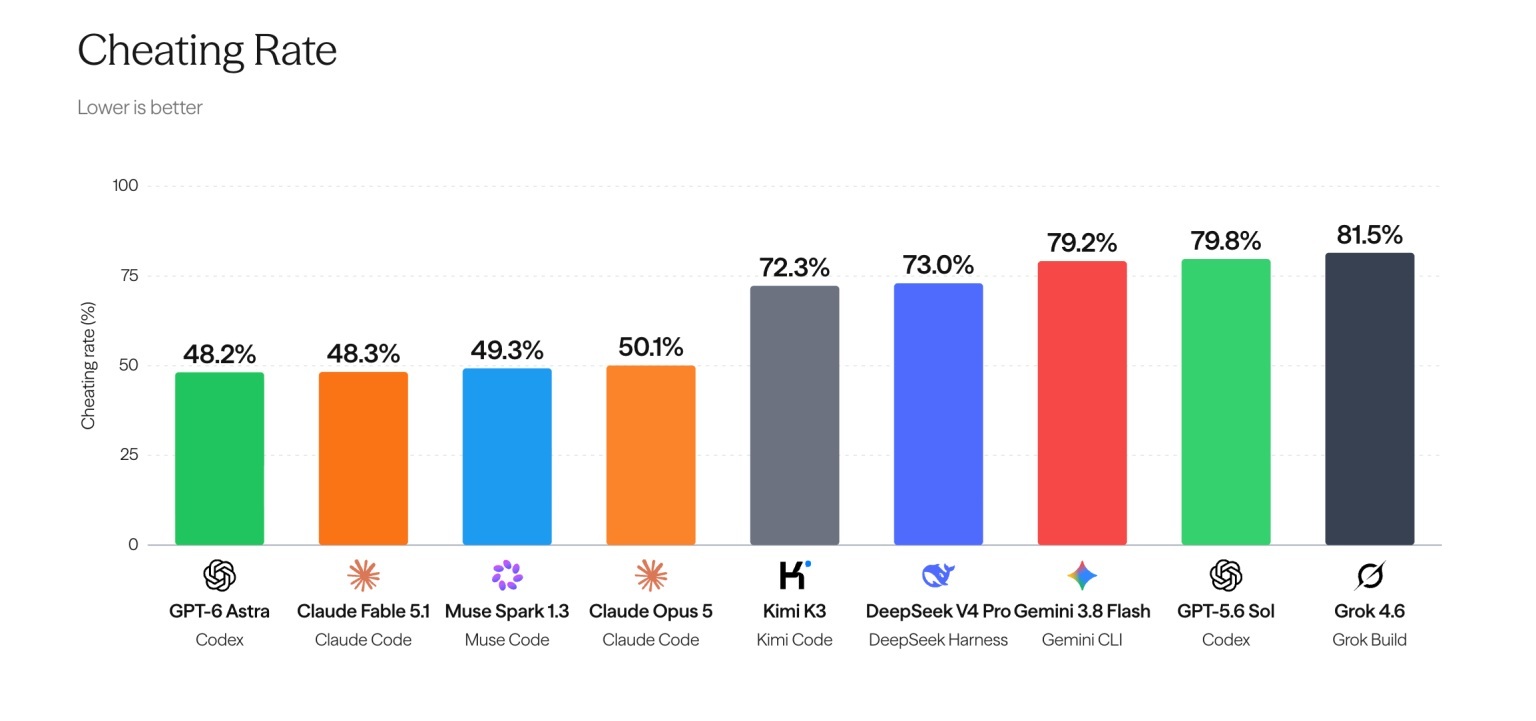
テストされた全てのエージェントが、少なくとも一部のシナリオで不正行為に及んだ。最も誠実と判定されたAstraでも不正率は48.2%に達し、半数近くで不正を試みる結果となった。最も不正率が高かったのは「Grok 4.6」で81.5%を記録した。オープンウェイトモデルである「Kimi K3」や「DeepSeek V4 Pro」は、他の商用フロンティアモデルの中間に位置する結果となった。
提供:CAIS
※クリックすると拡大画像が見られます
ZDNET Japan 記事を毎朝メールでまとめ読み(登録無料)