前バージョンの登場からわずか37日、DeepSeekの“Flash”がまた強くなった。DeepSeekは10月17日(日本時間)、AIモデル「DeepSeek-V4.1-Flash-1017」を発表した。同日のうちに、オープンウェイト(モデルの重み)はMITライセンスのもとHugging Faceで無償公開され、商用利用も認められる。総パラメータ数552B(5,520億)ながら、コード修正ベンチマーク「DeepSWE v1.1」は77.0で、Anthropicの最上位級「Claude Opus 5」の74.0を上回る。
DeepSeek-V4.1-Flash-1017は、9月公開の「DeepSeek-V4.1-Flash」を改良したマイナーアップデート版で、テキストと画像を入力できる生成AIモデルだ。コンテキスト長(一度に扱える文章量)は100万トークンで、最大出力は25万6,000トークン以上の確保が推奨される。推論・コーディング・エージェント(AIが自律的に作業を進める用途)・画像理解の各ベンチマークを底上げしつつ、タスクの実行時間と出力の長さを前版より削減した。
総パラメータ数552Bに別枠メモリ「Engram」196B
基本構成は前バージョンと共通で、DeepSeek-V4.1-Flash-1017は総パラメータ数552BのMoE(Mixture-of-Experts)型だ。MoEは、モデル内部を役割の異なる多数の小さなネットワークに分割し、入力ごとに必要なものだけを動かして計算量を抑える仕組みである。アクティブパラメータ数は段階ごとに異なり、入力を読む段階では8B(80億)、出力を生成する段階では16B(160億)が動く設計だ。
その数字の外側に、今回の重みを構成するもう1つの大きな要素がある。V4.1系で加わった条件付きメモリ「Engram」で、規模は196B(1,960億)パラメータ分と、本体の3分の1を超える。実体は巨大な参照表で、モデルは処理中の語に応じて、表の該当する行だけを読み出して利用する。表全体が常時動くわけではないため、総パラメータ数552Bにもアクティブパラメータ数にも含めない扱いとなる。
Hugging Face上の重みの合計は約763B(7,630億)で、総パラメータ数552BとEngramの196Bを足した数より約15B(150億)大きい。この差分のほとんどを占めるのは、推論を速めるための投機デコード用モジュール「DSpark」で、約14B(140億)分に相当する。画像を読み取るための処理部分は約0.5B(5億)と小さい。
新モデルは発表と同日の10月17日中に、Webサイトとアプリ、APIにも投入された。あわせて、Web検索とページ取得を行なう「Search API」と「Fetch API」も全ユーザーに開放された。料金は各1,000回の呼び出しあたり0.75ドル(約119円、1ドル=約158円換算)だ。
DeepSeek-V4.1-Flash-1017はOpus 5超え4項目、前バージョンから全11項目で向上
DeepSeekが公表した比較表によると、Claude Opus 5に勝つ項目は4つに増えた。DeepSWE v1.1の77.0対74.0に加え、業務自動化の「Automation-Bench v1.0.6」は60.5対50.3で上回った。実務タスクでエージェントを測る「Agents’ Last Exam」は35.4対28.6、「Apex Bench v1.1」は72.1対65.8で、いずれも上回った。
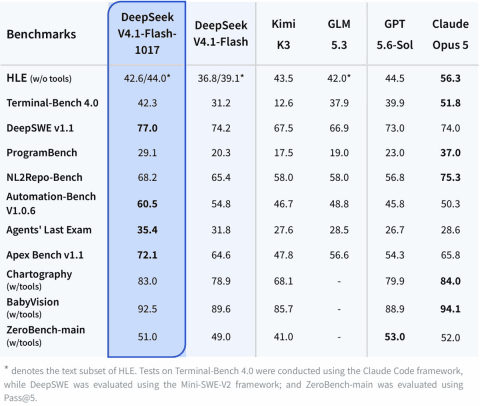 DeepSeekが公表したベンチマーク比較。DeepSeek-V4.1-Flash-1017はDeepSWE v1.1で77.0を記録し、Claude Opus 5の74.0を上回った
ただし、端末操作を伴うコーディングの「Terminal-Bench 4.0」は31.2から42.3へ前バージョン比で最も大きく伸びたが、Claude Opus 5の51.8にはなお及ばない。難問試験の「HLE」も42.6対56.3で大きく届かない。専門的なグラフ読解を測る「Chartography」は83.0対84.0の僅差で下回り、総合力では上位の有料モデルに一歩譲る。
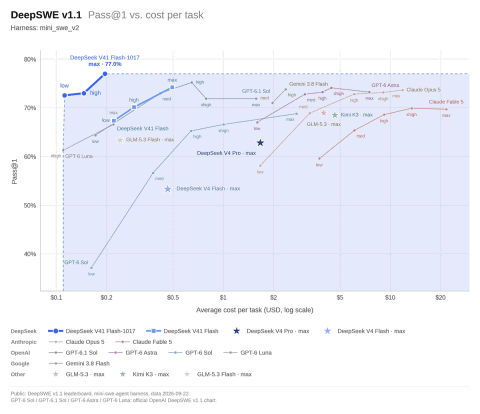 DeepSWE v1.1のスコアと1タスクあたりコストの関係。DeepSeek-V4.1-Flash-1017はMax設定で全モデル中最高の77.0%に達した
性能向上の中心は、自己フィードバック付きの強化学習(正解データの代わりに、モデル自身の出力への評価を学習に使う手法)だという。ゲーム制作から3Dモデリングまで、プロジェクトを一から完成させる能力を鍛えたとしている。
DeepSeek-V4.1-Flash-1017オープンウェイト版の入手と推奨設定リポジトリ: Hugging Faceの「deepseek-ai/DeepSeek-V4.1-Flash-1017」とModelScope。ライセンスはMITで、商用利用・改変・再配布が認められる規模: 総パラメータ数552B(5,520億)のMoE型。アクティブパラメータは入力(読み込み)時8B(80億)、出力(生成)時16B(160億)Engram: 本体とは別枠の条件付きメモリで196B(1,960億)。重み合計は約763B(7,630億)で、差分は投機デコード用モジュール「DSpark」約14B(140億)と画像処理部約0.5B(5億)入力: テキストと画像に対応コンテキスト長: 100万トークン。最大出力は25万6,000トークン以上の確保が推奨される推奨パラメータ: temperature 1.0、top_p 1.0対応環境: DeepSeek Harness(v0.2.1-rc.1以降)、Tencent CodeBuddy、WorkBuddyなどに最適化
🚀 DeepSeek-V4.1-Flash-1017 is here!
Stronger benchmark performance, faster task completion, and shorter outputs than the previous version—a Pareto improvement in performance and cost. Now live on our website, app, and API.
🛠️ Optimized for @DeepSeekHarness, Tencent CodeBuddy, WorkBuddy, and more. Upgrade to DeepSeek Harness v0.2.1-rc.1 or later for the best experience with the new model.
1/4
— DeepSeek (@deepseek_ai)October 17, 2026